Propensão de Compra para Cross-Sell de Seguros
Motivação
A All Insurance é uma seguradora de saúde que decidiu expandir para o ramo de seguros automotivos e quer oferecer o novo produto à própria base de clientes. No ano anterior, a empresa fez uma pesquisa de interesse com cerca de 380 mil clientes. Agora, o time de vendas vai oferecer o seguro a 127 mil novos clientes que não participaram da pesquisa, mas tem capacidade para fazer apenas 20 mil ligações durante a campanha.
Ligando sem nenhum critério, a taxa de conversão tende a ser igual à taxa de interesse da base: de cada 100 clientes contatados, apenas 12 têm interesse no produto. Com a capacidade limitada, cada ligação feita para um cliente sem interesse é uma ligação a menos para alguém que compraria.
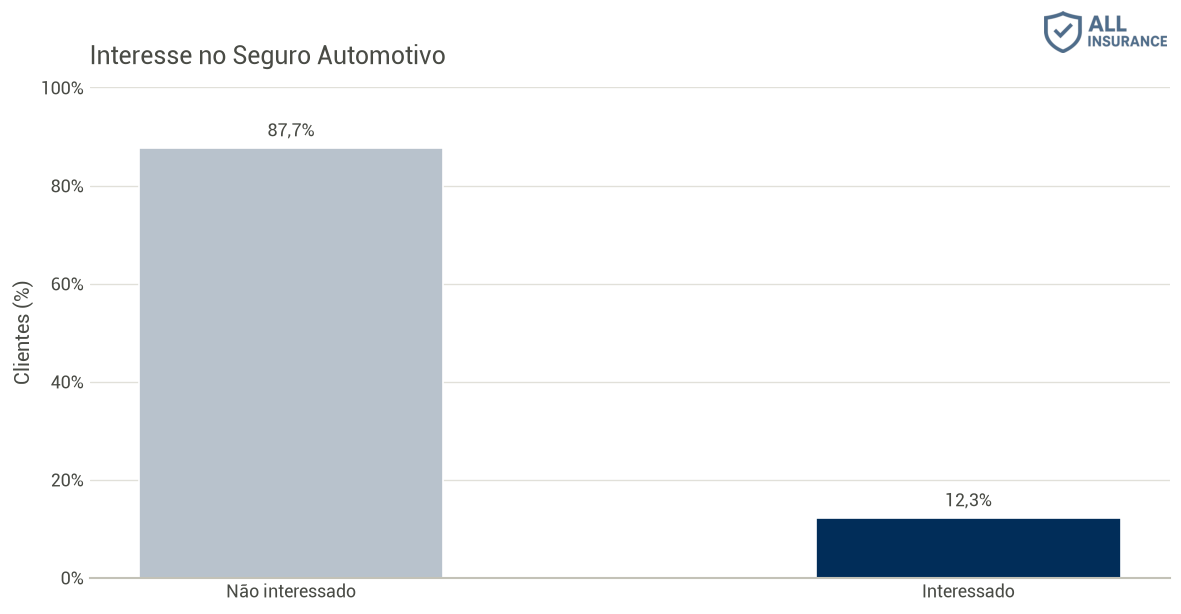
Figura 1: Apenas 12,3% dos clientes da pesquisa têm interesse no seguro automotivo.
Por isso, tratei o projeto como um problema de ranqueamento. O modelo calcula a probabilidade de compra de cada cliente, e é essa probabilidade que ordena a lista. Uma resposta de “sim” ou “não” não diria por quem começar, e dificilmente a lista de “sim” teria o tamanho exato da capacidade do time. Com a base ordenada, o time liga a partir do topo e para quando a capacidade acaba, seja ela de 20 ou de 40 mil ligações. Mais importante do que acertar se cada cliente vai comprar é garantir que os interessados estejam no topo.
Ferramentas Utilizadas
- PostgreSQL + SQL: armazenamento dos dados em três tabelas (clientes, apólices e veículos) e coleta com uma query de join.
- Python (Pandas, Scikit-learn, LightGBM): análise exploratória, preparação dos dados, modelagem e avaliação.
- Flask + Gunicorn: API REST que recebe os clientes e devolve o score de propensão de compra.
- Docker + Heroku: empacotamento da API em contêiner e deploy no Heroku Container Stack.
- Google Sheets + Apps Script: interface do time de vendas, que calcula o score e ordena a lista a partir de um menu na planilha.
- Pytest: testes automatizados da API.
Pipeline do Projeto
O projeto seguiu o CRISP-DM adaptado que descrevi neste post:
- Questão de negócio e definição da baseline: ligar sem nenhum critério.
- Coleta dos dados no PostgreSQL.
- Limpeza e engenharia de atributos.
- Análise exploratória com 10 hipóteses de negócio.
- Preparação dos dados: separação entre treino e teste, rescaling e encoding.
- Seleção de features por importância e por permutação.
- Comparação de algoritmos com cross validation e fine tuning do LightGBM.
- Avaliação para o negócio com curva de ganho e curva de lift.
- Deploy da API em Docker no Heroku e integração com o Google Sheets.
Desenvolvimento do Modelo
O desenvolvimento foi feito em um notebook que documenta cada etapa do ciclo.
A primeira fase foi a coleta. O cenário é fictício e usa o dataset público Health Insurance Cross Sell Prediction, do Kaggle. Para simular um ambiente real, os dados foram armazenados em um PostgreSQL, distribuídos em três tabelas ligadas pelo identificador do cliente, e a base é montada com uma query de join. Em seguida, separei os 381.109 clientes que responderam à pesquisa, usados para treinar e avaliar o modelo, dos 127.037 novos clientes, que seriam ranqueados para a campanha.
A segunda fase envolveu limpeza e engenharia de atributos. A base não tinha valores nulos além da própria resposta dos novos clientes, então o trabalho se concentrou em ajustar tipos, traduzir as categorias para facilitar a leitura dos gráficos e remover as chaves do banco, que não carregam informação sobre o cliente. Nenhuma linha foi descartada: mesmo os clientes sem carteira de motorista ficaram na base, já que podem contratar o seguro para o carro de outra pessoa da família.
A terceira fase foi a análise exploratória. O primeiro ponto de atenção foi o desbalanceamento: com apenas 12,3% de interessados, a acurácia deixa de fazer sentido, já que um modelo que classifica todos os clientes como “não interessados” acerta 87,7% das vezes e não tem utilidade nenhuma para o negócio. Para a análise bivariada, levantei 10 hipóteses a partir de atributos do cliente, da apólice e do veículo, e validei cada uma pela taxa de interesse do grupo, e não pela quantidade de interessados, para não ser enganado pelo tamanho dos grupos.
Os achados mais fortes vieram do histórico do cliente. Quem já possui seguro automotivo praticamente não tem interesse (0,1%, contra 22,5% de quem não possui), ou seja, ligar para esse cliente é desperdiçar uma ligação. Quem já teve o veículo danificado tem taxa de interesse de 23,8%, contra 0,5% dos demais. Algumas hipóteses intuitivas se mostraram falsas: o interesse cresce com a idade do veículo, e não com a do cliente, chegando a 29,4% entre os carros com mais de 2 anos. Entre os clientes, o pico fica entre 31 e 50 anos (21%), e os mais jovens, maior grupo da base, são os menos interessados. O canal de venda também pesa: o mais utilizado, responsável por 35% da base, tem taxa de interesse de apenas 2,9%.
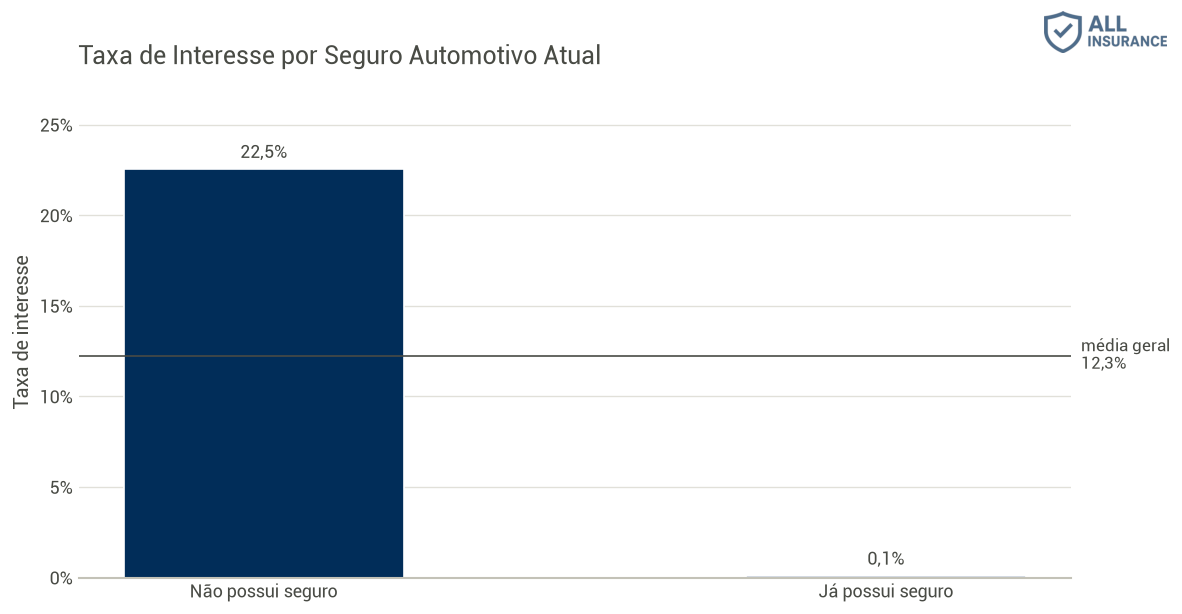
Figura 2: Taxa de interesse de quem já possui e de quem não possui seguro automotivo.
Na quarta fase, preparei os dados para os algoritmos. Separei a base em treino (80%) e teste (20%) de forma estratificada antes de qualquer transformação, para que scalers e encoders aprendessem só com o treino e o teste simulasse clientes nunca vistos pelo modelo. Como nenhuma variável numérica tinha distribuição normal, usei rescaling em vez de padronização: RobustScaler no prêmio anual, que tem muitos outliers, e MinMaxScaler na idade. Nas categóricas, apliquei binary encoding no gênero, ordinal encoding na idade do veículo, respeitando a ordem natural das categorias, e target encoding na região e no canal de venda. O TargetEncoder do scikit-learn usa cross fitting no treino: o valor de cada cliente é calculado com dados dos quais ele não faz parte, para que o encoding não carregue a resposta do próprio cliente.
Para a seleção de features, calculei a importância de duas formas: pela redução de impureza de um Extra Trees e por permutação, que mede o quanto a performance cai quando cada feature é embaralhada. As duas apontaram o histórico de seguro, o histórico de dano, a idade, o canal de venda e a idade do veículo como as mais importantes. O tempo de relacionamento com a empresa saiu do modelo: além de não ter relação com o interesse na análise exploratória, sua importância por permutação era praticamente nula.
Na fase de modelagem, comparei seis algoritmos: um linear (Regressão Logística), um baseado em distância (KNN) e quatro baseados em árvores (Random Forest, Extra Trees, XGBoost e LightGBM). Como o objetivo é ordenar a base, as métricas também precisavam ser de ranqueamento. A Precision@K mede quantos dos K primeiros clientes da lista têm interesse, e o Recall@K mede quantos dos interessados estão entre os K primeiros. O K corresponde à capacidade do time: 20 mil ligações em 127.037 clientes, ou 15,74% da base. Todos os modelos passaram por cross validation estratificado de 5 folds e foram comparados com um modelo aleatório, que representa ligar sem critério.
| Modelo | Precision@K | Recall@K | ROC AUC |
|---|---|---|---|
| XGBoost | 0,3710 ± 0,0048 | 0,4766 ± 0,0062 | 0,8567 ± 0,0023 |
| LightGBM | 0,3710 ± 0,0052 | 0,4765 ± 0,0067 | 0,8569 ± 0,0021 |
| Extra Trees | 0,3691 ± 0,0036 | 0,4740 ± 0,0046 | 0,8555 ± 0,0018 |
| Random Forest | 0,3574 ± 0,0036 | 0,4591 ± 0,0047 | 0,8506 ± 0,0019 |
| KNN | 0,3475 ± 0,0040 | 0,4463 ± 0,0051 | 0,8445 ± 0,0016 |
| Regressão Logística | 0,3412 ± 0,0035 | 0,4383 ± 0,0045 | 0,8437 ± 0,0018 |
| Modelo aleatório | 0,1220 | 0,1568 | 0,4990 |
XGBoost e LightGBM ficaram praticamente empatados, com cerca de 3 vezes mais interessados do que o modelo aleatório no mesmo número de ligações. Escolhi o LightGBM por um critério de engenharia: a performance é equivalente, mas o treinamento foi mais rápido e o modelo final ficou um pouco menor, o que agiliza o fine tuning e facilita a manutenção da API em produção.
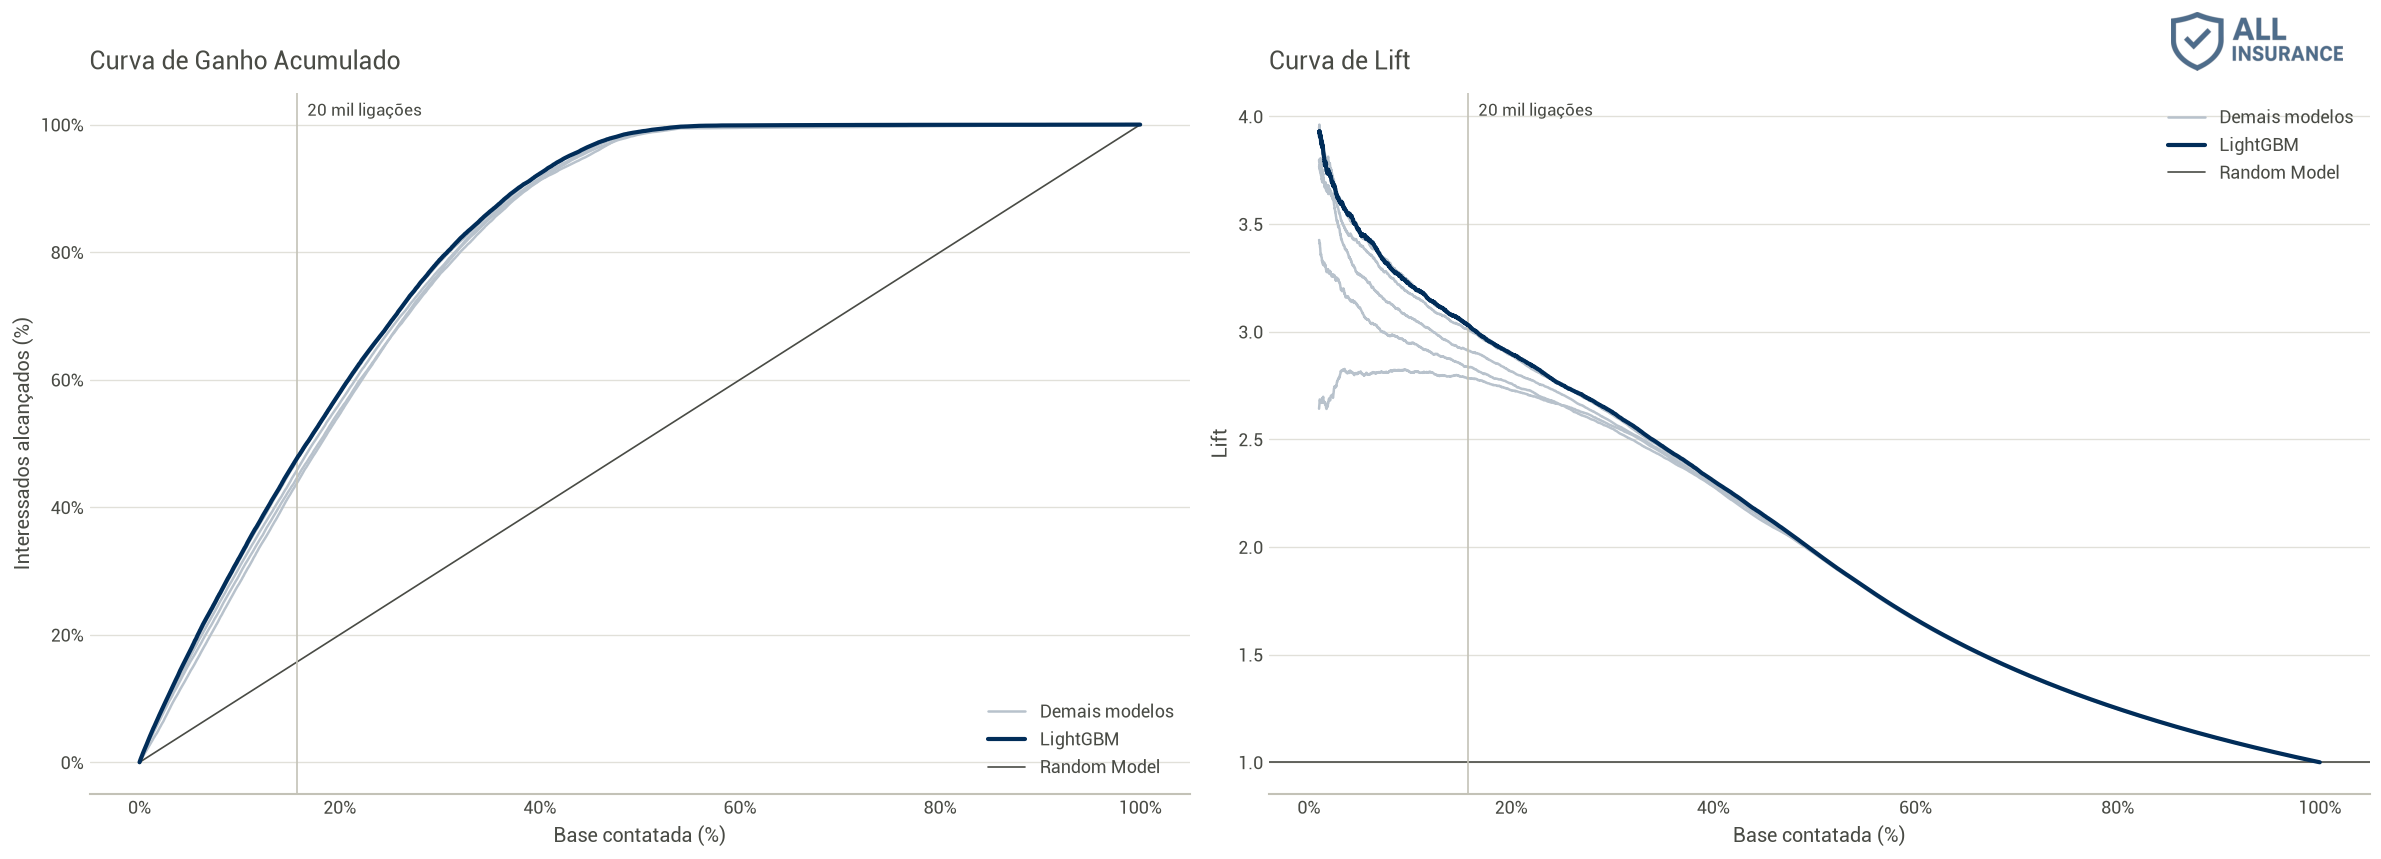
Figura 3: Curva de ganho e curva de lift dos algoritmos testados, com o LightGBM em destaque.
Por fim, otimizei os hiperparâmetros do LightGBM com Random Search, escolhendo o melhor conjunto pelo maior Recall@K médio e, em caso de empate, pelo maior ROC AUC. Na base de teste, que não participou do treinamento, da cross validation nem do tuning, o modelo final chegou a Precision@K de 0,3706 e Recall@K de 0,4760, praticamente iguais aos da cross validation (0,3720 e 0,4778). O modelo generaliza bem para clientes que nunca viu e não há sinais de overfitting. Na prática, de cada 100 clientes no topo da lista, cerca de 37 têm interesse no seguro, contra 12 em uma escolha aleatória.
Resultado para o Negócio
Precision@K e Recall@K ajudam a escolher o modelo, mas dizem pouco para quem planeja uma campanha. Para traduzir o desempenho, projetei os resultados da base de teste para os 127.037 novos clientes. Como 12,3% dos clientes da pesquisa demonstraram interesse, a estimativa é de cerca de 15.570 interessados entre os novos clientes.
A curva de ganho acumulado mostra a porcentagem dos interessados alcançados à medida que o time avança na lista, e a curva de lift mostra quantas vezes o modelo é melhor do que ligar sem critério em cada ponto dela. No topo da lista, o lift chega perto de 4, e no limite das 20 mil ligações ainda é de 3,0. A curva de ganho também mostra que praticamente todos os interessados estão na primeira metade da lista, o que conversa com a análise exploratória: cerca de metade da base já possui seguro automotivo e vai, com razão, para o fim da fila.
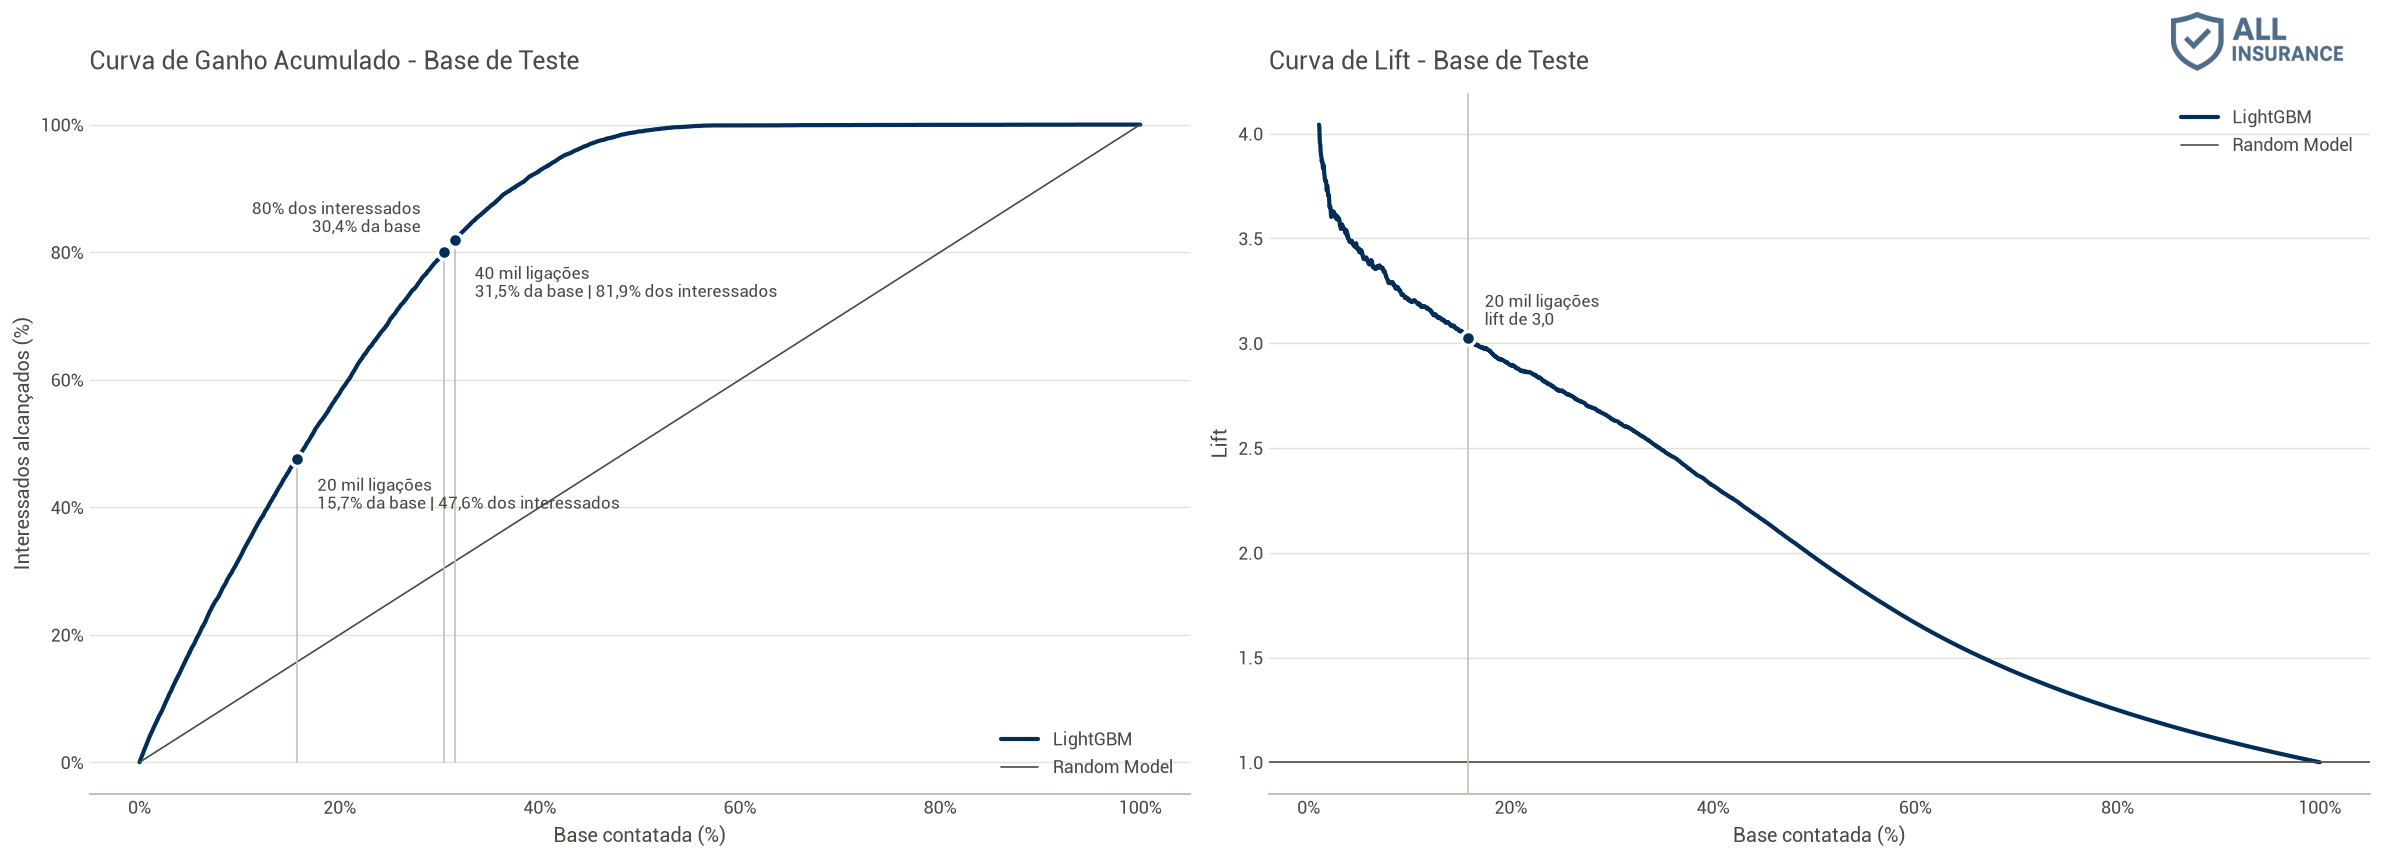
Figura 4: Curva de ganho acumulado e curva de lift do LightGBM na base de teste.
A tabela abaixo resume os cenários da campanha:
| Cenário | Ligações | Interessados alcançados (modelo) | Interessados alcançados (aleatório) | Ganho |
|---|---|---|---|---|
| Capacidade atual | 20.000 | 7.412 (47,6%) | 2.451 (15,7%) | 3,0x |
| Capacidade dobrada | 40.000 | 12.745 (81,9%) | 4.903 (31,5%) | 2,6x |
| 80% dos interessados | 38.662 | 12.456 (80,0%) | 4.739 (30,4%) | 2,6x |
O número que mais interessa ao negócio é o de ligações economizadas. Sem o modelo, alcançar os mesmos 7.412 interessados exigiria 60.472 ligações. Com ele, o time chega ao mesmo resultado com as 20 mil ligações que já tem, ou seja, mais de 40 mil ligações a menos (66,9%), o que reduz o custo da campanha e aumenta a taxa de conversão das ofertas. E para alcançar 80% dos interessados, bastam 38.662 ligações, contra 101.630 ligando sem critério.
Deploy e Integrações
Com o modelo validado, avancei para o deploy. A ideia era que o time de vendas calculasse a propensão de compra no Google Sheets, ferramenta que ele já usa no dia a dia, sem precisar de nenhum conhecimento técnico. Para isso, construí duas peças: uma API que calcula o score e um script do Google Apps Script que conecta a planilha à API.
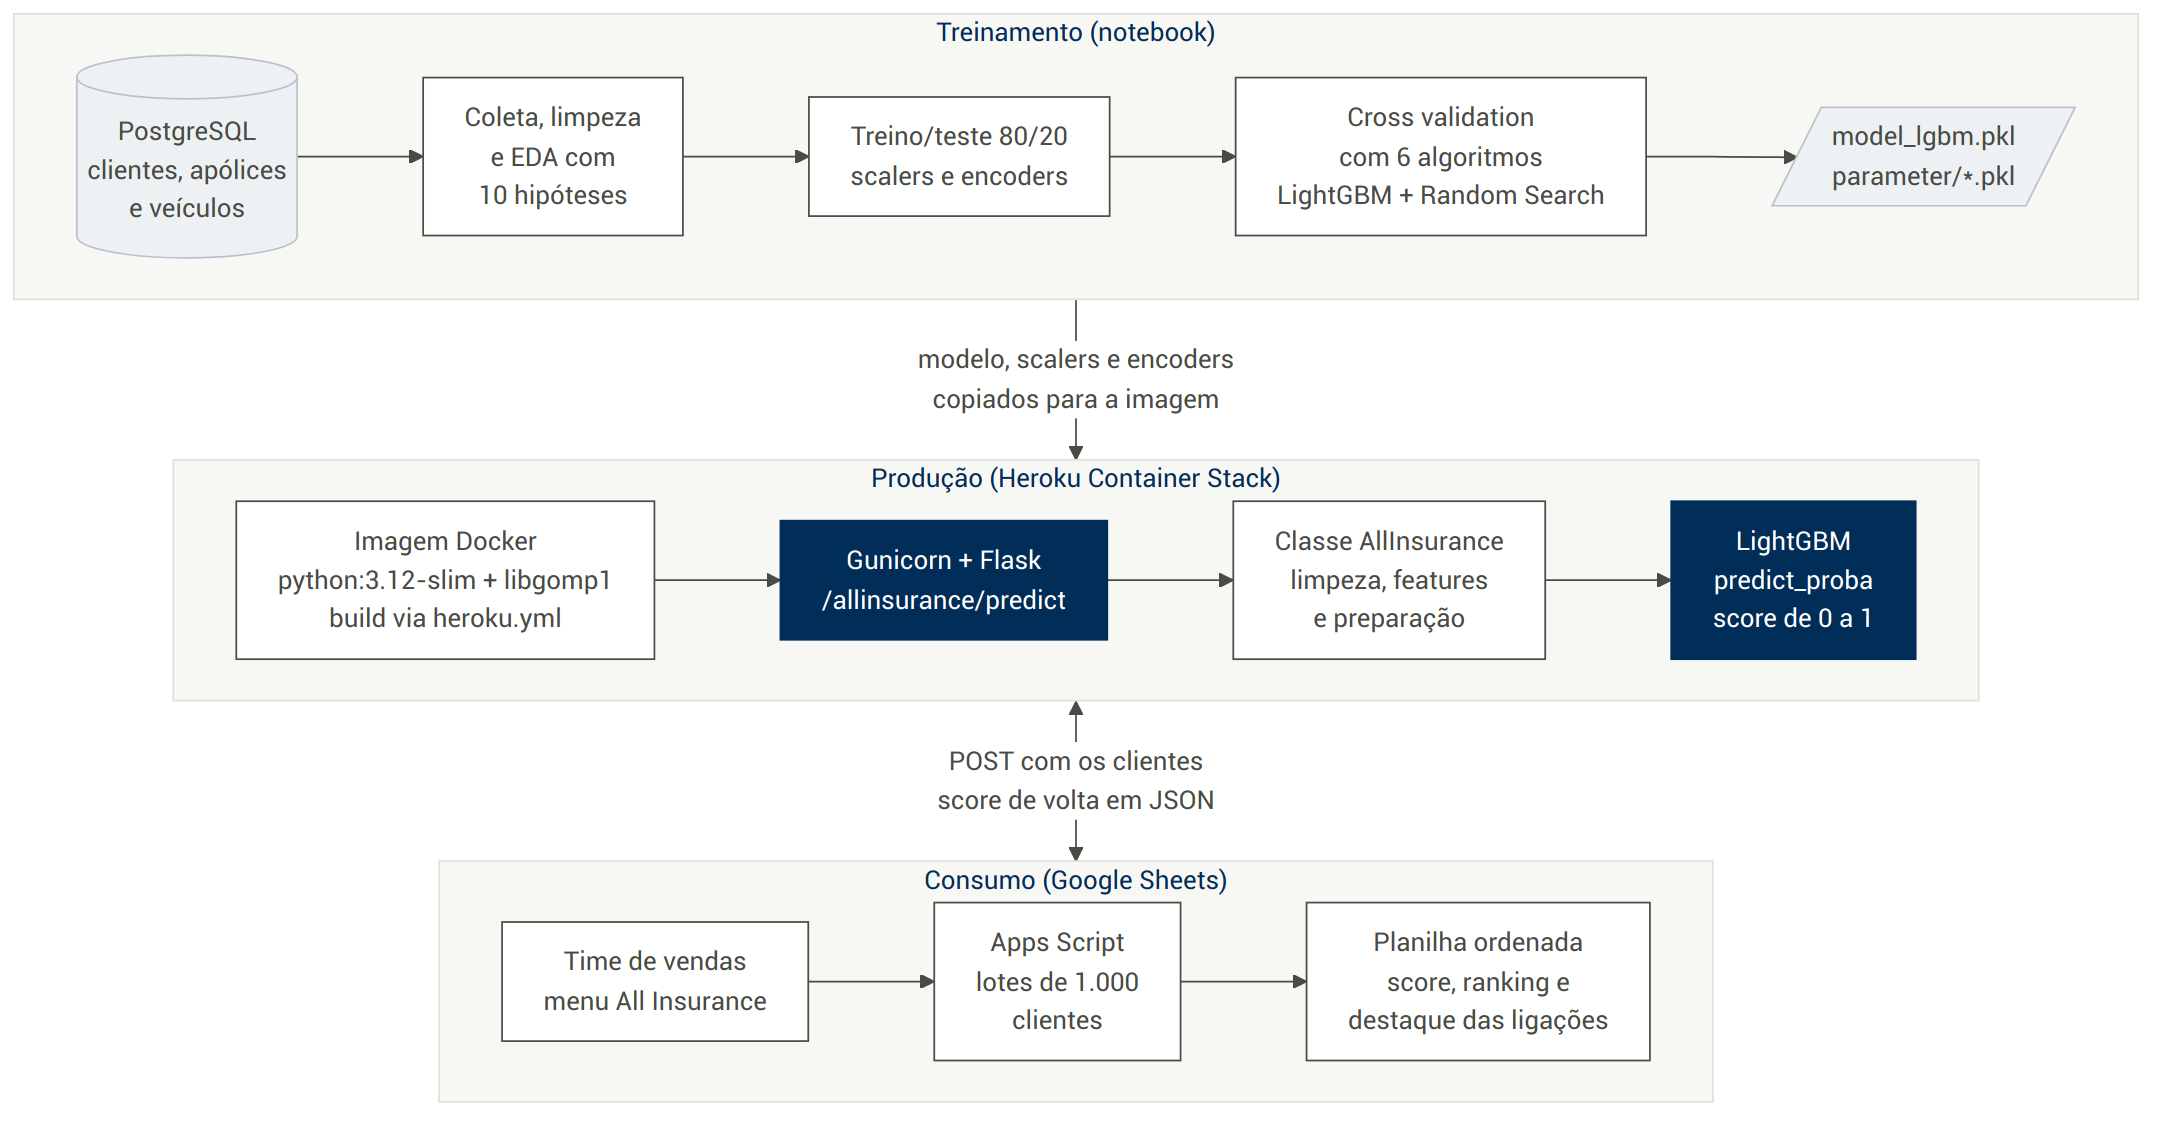
Figura 5: Arquitetura da solução, do treinamento do modelo à planilha do time de vendas.
A API REST em Flask recebe os clientes em JSON, no mesmo formato das tabelas do banco. O código é modular e orientado a objetos: o handler.py expõe o endpoint /allinsurance/predict, e a classe AllInsurance carrega uma única vez os scalers e encoders salvos no treinamento, aplica as mesmas transformações do notebook, na mesma ordem de features, e devolve os dados originais acrescidos da coluna score. Para garantir que a API reproduz o notebook, comparei os scores devolvidos por ela com os calculados no notebook para uma amostra de novos clientes.
Como os dados podem ser digitados na planilha, a API também valida a entrada. Espaços extras e diferenças entre maiúsculas e minúsculas são ignorados, enquanto colunas ausentes, categorias desconhecidas ou valores numéricos inválidos retornam um erro 400 com a descrição do problema, em vez de um score errado. Esses comportamentos são cobertos por testes automatizados com pytest.
Para o deploy, empacotei a API em um contêiner Docker a partir da imagem python:3.12-slim, com a biblioteca libgomp1 instalada: o LightGBM depende do OpenMP, que não vem na imagem slim. O Heroku Container Stack constrói a imagem a partir do manifesto heroku.yml, e a API é servida pelo Gunicorn, com um worker e duas threads. No plano Eco do Heroku, a API “dorme” após 30 minutos sem uso, então o script da planilha tenta acordá-la algumas vezes antes de enviar os clientes.
Na planilha, o script cria um menu All Insurance com duas opções. A primeira, Calcular propensão de compra, envia para a API apenas as colunas que o modelo utiliza, em lotes de mil clientes, escreve o score e a posição de cada cliente no ranking e ordena a lista do maior para o menor score. A segunda, Destacar clientes para ligação, pergunta quantas ligações o time consegue fazer e destaca os clientes do topo. Assim, a mesma planilha atende à capacidade atual de 20 mil ligações e a qualquer outra que o time venha a ter.
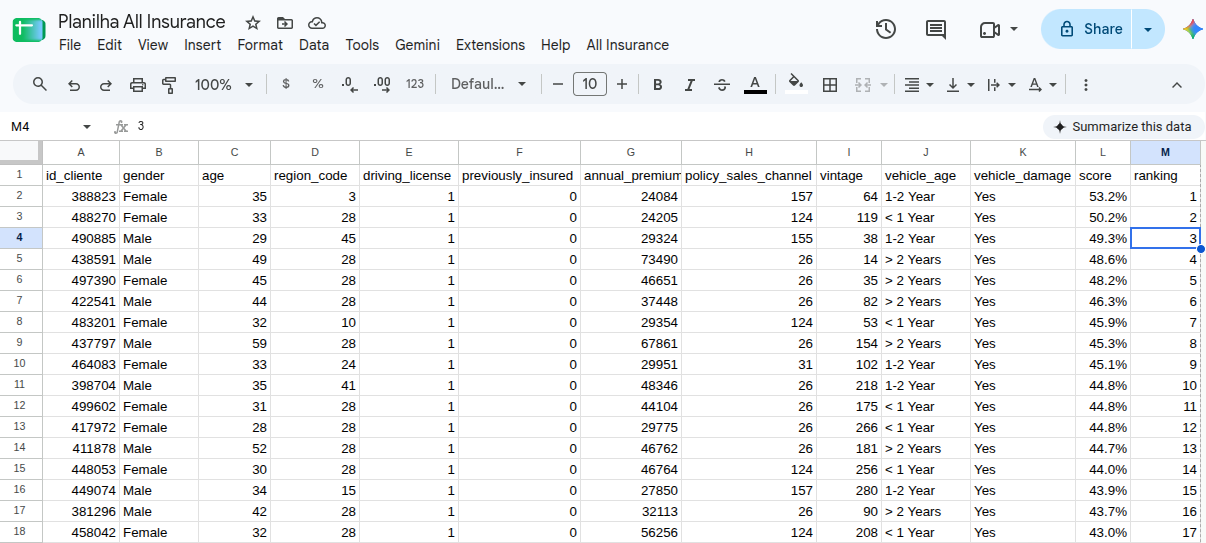
Figura 6: Planilha do time de vendas após o cálculo da propensão de compra, com os clientes ordenados pelo score.
Resultados e Aprendizados
Com o modelo, o time de vendas alcança 3 vezes mais clientes interessados com as mesmas 20 mil ligações, ou chega ao mesmo resultado com 40 mil ligações a menos. E o resultado não fica preso em um notebook: ele chega como uma lista de prioridades dentro da ferramenta que o time já usa, pronta para qualquer capacidade de ligações.
O principal aprendizado foi deixar a restrição do negócio guiar as decisões técnicas. A capacidade de ligações definiu o enquadramento como ranqueamento, a troca da acurácia por Precision@K e Recall@K, o valor de K e até a forma de apresentar os resultados, em ligações e clientes alcançados, e não em métricas técnicas. Outro ponto foi tratar o vazamento de dados desde o início, separando treino e teste antes de qualquer transformação e usando target encoding com cross fitting. O resultado aparece na base de teste, com performance praticamente igual à da cross validation.
Do lado da engenharia, ficou claro que colocar um modelo em produção vai além de publicar uma API. É preciso validar a entrada, garantir que a API reproduz o notebook, empacotar as dependências certas e lidar com detalhes da infraestrutura, como a API que dorme no plano Eco. Um modelo só gera valor quando o time de vendas consegue usá-lo sem pedir ajuda a ninguém.
Como o CRISP-DM é cíclico, o próximo ciclo tem caminhos claros: entender com o time de negócio por que 17% dos clientes pagam exatamente o prêmio mínimo e por que alguns canais de venda têm taxa de interesse tão baixa; incorporar o custo de cada ligação e a receita de cada venda para definir a quantidade de ligações que maximiza o lucro da campanha; retreinar o modelo com toda a base da pesquisa e atualizar a API; e acompanhar a taxa de conversão real das ligações para monitorar o modelo ao longo do tempo.